Haar vs. Daubechies vs. Symlets: Evaluación Empírica de Wavelets 2D en Redes Convolucionales
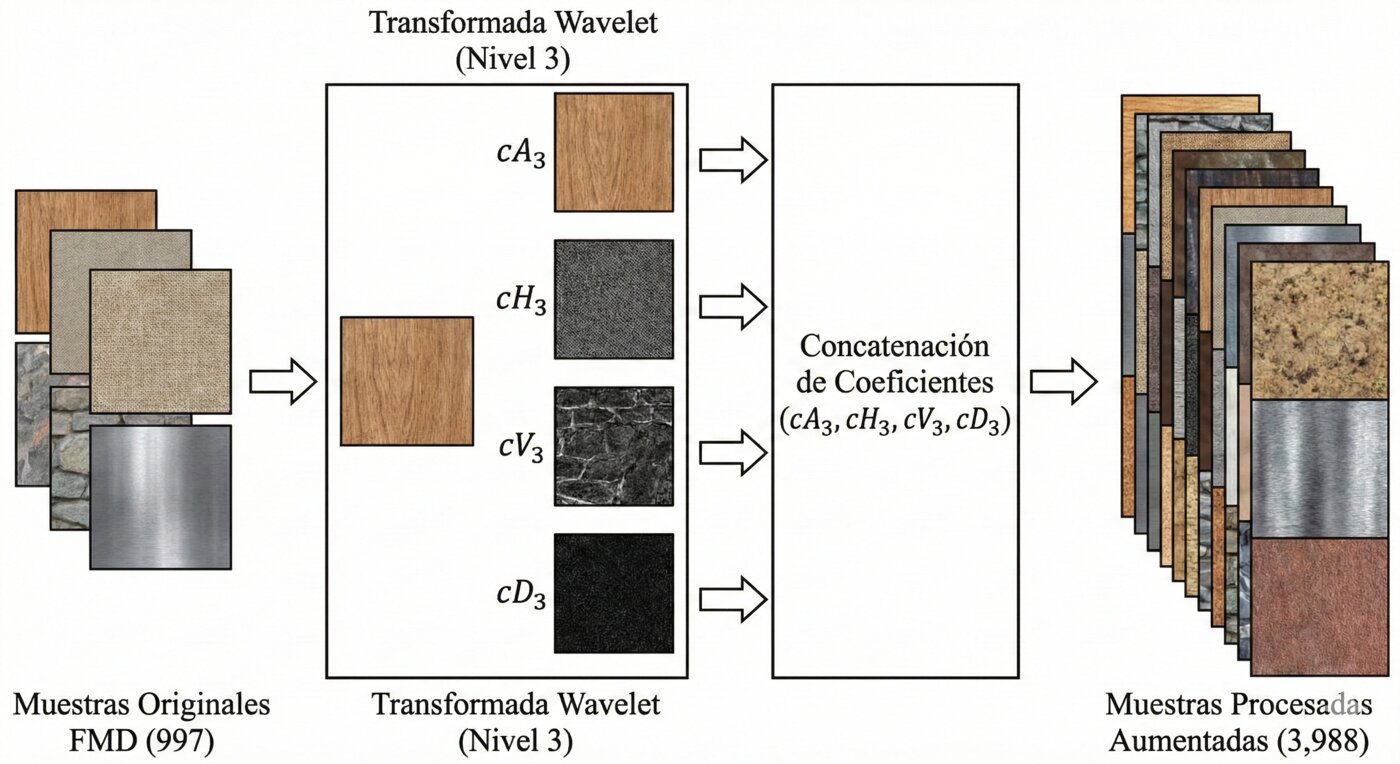
Figura metodológica de mi investigación: descomposición wavelet discreta en 3 niveles ($cA_3, cH_3, cV_3, cD_3$) y concatenación multiescala aplicada a muestras de texturas para alimentar la red convolucional profunda.
Cuando abordé el problema de clasificar materiales y texturas complejas (madera, cuero, vidrio, tela, plástico) en mi investigación, me topé de inmediato con una limitación fundamental de las redes neuronales convolucionales estándar: el diezmado ciego del pooling espacial.
Capas como MaxPooling2D o AveragePooling2D están diseñadas para otorgar invariancia a pequeñas traslaciones. Sin embargo, en el reconocimiento de superficies microscópicas y materiales del mundo real, la identidad del objeto reside precisamente en las altas frecuencias direccionales y en las micro-variaciones de rugosidad. Al aplicar pooling tradicional, la red descarta gradientes críticos que diferencian una tela de un plástico rugoso.
La alternativa que exploré en mi investigación consiste en sustituir o complementar el preprocesamiento espacial mediante la Transformada Wavelet Discreta 2D (2D-DWT). Al descomponer la imagen en una base multirresolución de espacio y frecuencia, la red recibe subbandas espectrales separadas.
Pero surgió la gran interrogante: ¿qué familia wavelet elegir? En la literatura clásica de procesamiento de señales suele afirmarse que funciones con mayor regularidad matemática y más momentos de desvanecimiento capturan mejor la información continua. En este post comparto los experimentos y el análisis matemático que refutan esa intuición en el contexto de las CNNs.
1. Fundamento Matemático: La Pirámide 2D de Mallat
En la formulación clásica de multirresolución propuesta por Stéphane Mallat (1989), una señal bidimensional continua $f(x,y) \in L^2(\mathbb{R}^2)$ se descompone mediante el producto tensorial separable de una función de escala unidimensional $\phi(t)$ y una ondícula madre $\psi(t)$.
A nivel discreto, este proceso se implementa mediante un banco de filtros en cuadratura:
- Un filtro pasa-bajas de escalamiento $h[n]$ con respuesta al impulso asociada a $\phi$.
- Un filtro pasa-altas de ondícula $g[n]$ con respuesta asociada a $\psi$, donde para wavelets ortogonales se cumple la relación de espejo en cuadratura: \(g[n] = (-1)^n h[1 - n]\)
Al proyectar una matriz de imagen digital $A_{j-1}$ en dos dimensiones a lo largo de las filas y columnas sucesivamente, seguida de un diezmado (downsampling) de factor 2 ($2\downarrow 1$), obtenemos cuatro subbandas en el nivel de descomposición $j$:
\[cA_j[m, n] = \sum_k \sum_l h[k - 2m] h[l - 2n] cA_{j-1}[k, l] \quad (\text{Subbanda } LL)\] \[cH_j[m, n] = \sum_k \sum_l h[k - 2m] g[l - 2n] cA_{j-1}[k, l] \quad (\text{Subbanda } LH)\] \[cV_j[m, n] = \sum_k \sum_l g[k - 2m] h[l - 2n] cA_{j-1}[k, l] \quad (\text{Subbanda } HL)\] \[cD_j[m, n] = \sum_k \sum_l g[k - 2m] g[l - 2n] cA_{j-1}[k, l] \quad (\text{Subbanda } HH)\]Cada una de estas subbandas aísla un componente físico de la textura:
- $cA_j$ ($LL$): Coeficiente de aproximación. Preserva el contenido estructural de baja frecuencia e iluminación general.
- $cH_j$ ($LH$): Detalle horizontal. Resalta bordes y transiciones perpendiculares al eje vertical.
- $cV_j$ ($HL$): Detalle vertical. Captura fronteras y ranuras a lo largo del eje vertical.
- $cD_j$ ($HH$): Detalle diagonal. Registra esquinas, ruido textural fino y componentes cruzados de alta frecuencia.
Al iterar este análisis de manera recursiva sobre la subbanda de aproximación ($cA_0 \to cA_1 \to cA_2 \to cA_3$), una imagen de entrada de $300 \times 300$ píxeles se reduce espacialmente a un tensor compacto de $38 \times 38$, conservando la energía espectral en lugar de desecharla como hace un max pooling.
2. Las Cinco Familias Evaluadas
Para contrastar el impacto de la base matemática en el aprendizaje de la CNN (Daubechies, 1992; Lee et al., 2020), seleccioné cinco familias con propiedades dispares de soporte, simetría y regularidad:
| Wavelet | Familia | Longitud del Filtro ($L$) | Ortogonal | Biortogonal | Simetría | Momentos de Desvanecimiento ($p$) |
|---|---|---|---|---|---|---|
haar | Haar | 2 | Sí | Sí | Asimétrica | 1 |
bior1.1 | Biorthogonal | 2 | No | Sí | Simétrica pura | 1 |
sym2 | Symlets | 4 | Sí | Sí | Casi simétrica | 2 |
coif1 | Coiflets | 6 | Sí | Sí | Casi simétrica | 2 (en $\phi$ y $\psi$) |
db10 | Daubechies | 20 | Sí | Sí | Fuertemente asimétrica | 10 |
El script de extracción en Python hace uso de pywt.wavedec2 (PyWavelets Contributors, 2019) para aislar los coeficientes multinivel:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import pywt
import numpy as np

def extract_dwt_level3(image_array, wavelet='haar'):
    """
    Descompone una imagen bidimensional en 3 niveles con PyWavelets.
    Retorna la aproximación cA3 y los detalles direccionales.
    """
    if len(image_array.shape) == 3:
        image_array = image_array[:, :, 0]  # Canal monocromático

    # Descomposición piramidal a 3 niveles
    coeffs = pywt.wavedec2(image_array, wavelet=wavelet, level=3)
    cA3, (cH3, cV3, cD3), (cH2, cV2, cD2), (cH1, cV1, cD1) = coeffs

    return cA3, (cH3, cV3, cD3)
3. Metodología Experimental y Arquitectura CNN
Diseñé un banco de pruebas controlado para someter a cada familia exactamente a las mismas condiciones de optimización:
- Datasets:
- FMD (Flickr Material Database): 10 categorías de materiales reales con variabilidad lumínica y deformaciones de superficie (fabric, foliage, glass, leather, metal, paper, plastic, stone, water, wood) recolectadas del mundo real (Sharan et al., 2014). 100 muestras por categoría ($N = 1000$ imágenes originales).
- KTH-TIPS-2b: Benchmark industrial de texturas bajo variaciones controladas de escala, ángulo de iluminación y pose (Caputo et al., 2005).
- Preprocesamiento: Conversión a escala de grises, redimensionado inicial a $300 \times 300$, descomposición 2D-DWT a nivel 3 (tamaño de entrada resultante: $38 \times 38 \times 1$) y normalización con
MinMaxScaleren rango $[0, 1]$. - Partición: 80% entrenamiento, 20% prueba, con un 20% del entrenamiento reservado para validación interna. Semilla determinista fija (
SEED = 42).
Arquitectura Propuesta: Red Funcional Multiescala de Fusión Jerárquica
Para este proyecto de investigación en clasificación de texturas mediante aprendizaje profundo, no utilicé una red secuencial elemental. Diseñé una arquitectura funcional multiescala inspirada en los principios de profundidad de VGG16 (Simonyan & Zisserman, 2014), con filtros de $3 \times 3$ y activación ReLU, pero estructurada mediante la API Funcional de Keras para operar con cuatro ramas de entrada independientes que convergen jerárquicamente por capas:
- Rama Espacial (
Input_Raw): Ingesta la imagen cruda a resolución completa ($300 \times 300 \times 1$), preservando la textura local y las fronteras de alta frecuencia. - Ramas Espectrales (
Input_L1,Input_L2,Input_L3): Tres ramas que reciben directamente los coeficientes de aproximación ($cA$) de la descomposición piramidal 2D-DWT a dimensiones de $150 \times 150 \times 1$, $75 \times 75 \times 1$ y $38 \times 38 \times 1$, inyectando resúmenes de energía en distintas bandas base.
En cada transición de bloque, tras la reducción de resolución espacial (pooling), se realiza una concatenación por canales (channel-wise concatenation) fusionando la representación convolucional aprendida con la subbanda wavelet correspondiente mediante capas de redimensionamiento (Resizing):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
from keras.models import Model
from keras.layers import Input, Conv2D, MaxPooling2D, Resizing, concatenate, GlobalAveragePooling2D, Dropout, Dense
from keras.optimizers import Adam

def build_multiscale_wavelet_cnn(shape_raw=(300, 300, 1),
                                  shape_L1=(150, 150, 1),
                                  shape_L2=(75, 75, 1),
                                  shape_L3=(38, 38, 1),
                                  num_classes=10,
                                  dropout=0.4,
                                  lr=1e-4):
    # 1. Cuatro Entradas Simultáneas
    input_raw = Input(shape=shape_raw, name="Input_Raw")
    input_l1  = Input(shape=shape_L1,  name="Input_L1_DWT")
    input_l2  = Input(shape=shape_L2,  name="Input_L2_DWT")
    input_l3  = Input(shape=shape_L3,  name="Input_L3_DWT")

    # --- BLOQUE 1: Fusión Espacial + Wavelet L1 (64 filtros) ---
    l1_pool = MaxPooling2D(pool_size=(2, 2), strides=(2, 2), name='block1_Pool')(input_raw)
    conv1 = Conv2D(64, (3, 3), strides=1, padding='same', activation='relu', name='block1_conv1')(input_raw)
    conv2 = Conv2D(64, (3, 3), strides=2, padding='same', activation='relu', name='block1_conv2')(conv1)

    target_h1, target_w1 = conv2.shape[1], conv2.shape[2]
    conv_l1 = Conv2D(64, (3, 3), strides=1, padding='same', activation='relu', name='block1_conv_L1')(input_l1)
    conv_l1_resized = Resizing(target_h1, target_w1, name='Resize_L1')(conv_l1)

    concat1 = concatenate([conv2, conv_l1_resized, l1_pool], name='channel_concat_1')

    # --- BLOQUE 2: Fusión con Wavelet L2 (128 filtros) ---
    conv3 = Conv2D(128, (3, 3), strides=1, padding='same', activation='relu', name='block2_conv1')(concat1)
    conv4 = Conv2D(128, (3, 3), strides=2, padding='same', activation='relu', name='block2_conv2')(conv3)

    target_h2, target_w2 = conv4.shape[1], conv4.shape[2]
    conv_l2 = Conv2D(64, (3, 3), strides=1, padding='same', activation='relu', name='block2_conv_L2_1')(input_l2)
    conv_l2_deep = Conv2D(128, (3, 3), strides=1, padding='same', activation='relu', name='block2_conv_L2_2')(conv_l2)
    conv_l2_resized = Resizing(target_h2, target_w2, name='Resize_L2')(conv_l2_deep)

    l2_pool = MaxPooling2D(pool_size=(2, 2), strides=(2, 2), name='block2_Pool')(concat1)
    concat2 = concatenate([conv4, conv_l2_resized, l2_pool], name='channel_concat_2')

    # --- BLOQUE 3: Fusión con Wavelet L3 (256 filtros) ---
    conv6 = Conv2D(256, (3, 3), strides=1, padding='same', activation='relu', name='block3_conv1')(concat2)
    conv7 = Conv2D(256, (3, 3), strides=2, padding='same', activation='relu', name='block3_conv2')(conv6)

    target_h3, target_w3 = conv7.shape[1], conv7.shape[2]
    conv_l3_1 = Conv2D(128, (3, 3), strides=1, padding='same', activation='relu', name='block3_conv_L3_1')(input_l3)
    conv_l3_2 = Conv2D(256, (3, 3), strides=1, padding='same', activation='relu', name='block3_conv_L3_2')(conv_l3_1)
    conv_l3_resized = Resizing(target_h3, target_w3, name='Resize_L3')(conv_l3_2)

    l3_pool = MaxPooling2D(pool_size=(2, 2), strides=(2, 2), padding='same', name='block3_Pool')(concat2)
    concat3 = concatenate([conv7, conv_l3_resized, l3_pool], name='channel_concat_3')

    # --- BLOQUE 4: Extracción de Rasgos Globales (512 filtros) ---
    conv8 = Conv2D(512, (3, 3), strides=1, padding='same', activation='relu', name='block4_conv1')(concat3)
    conv9 = Conv2D(512, (3, 3), strides=2, padding='same', activation='relu', name='block4_conv2')(conv8)

    # Cabezal de Clasificación
    gap = GlobalAveragePooling2D(name='GlobalAvgPool')(conv9)
    drop = Dropout(dropout, name='Dropout')(gap)
    output = Dense(num_classes, activation='softmax', name='Output')(drop)

    model = Model(inputs=[input_raw, input_l1, input_l2, input_l3], outputs=output, name="WCNN_Multiscale_Fusion")
    model.compile(optimizer=Adam(learning_rate=lr, beta_1=0.9, beta_2=0.999, epsilon=1e-08),
                  loss='categorical_crossentropy', metrics=['accuracy'])
    return model
Dimensiones y Complejidad del Modelo
- Total de Parámetros Entrenables: 8,682,187 parámetros.
- Huella en Memoria: 33.12 MB (pesos en precisión flotante de 32 bits).
- Mapeo Multidimensional Simultáneo: Procesar simultáneamente 4 entradas acopladas por convolución y pooling en cascada genera un grafo de cómputo sumamente denso con miles de mapas de activación activos por paso forward/backward.
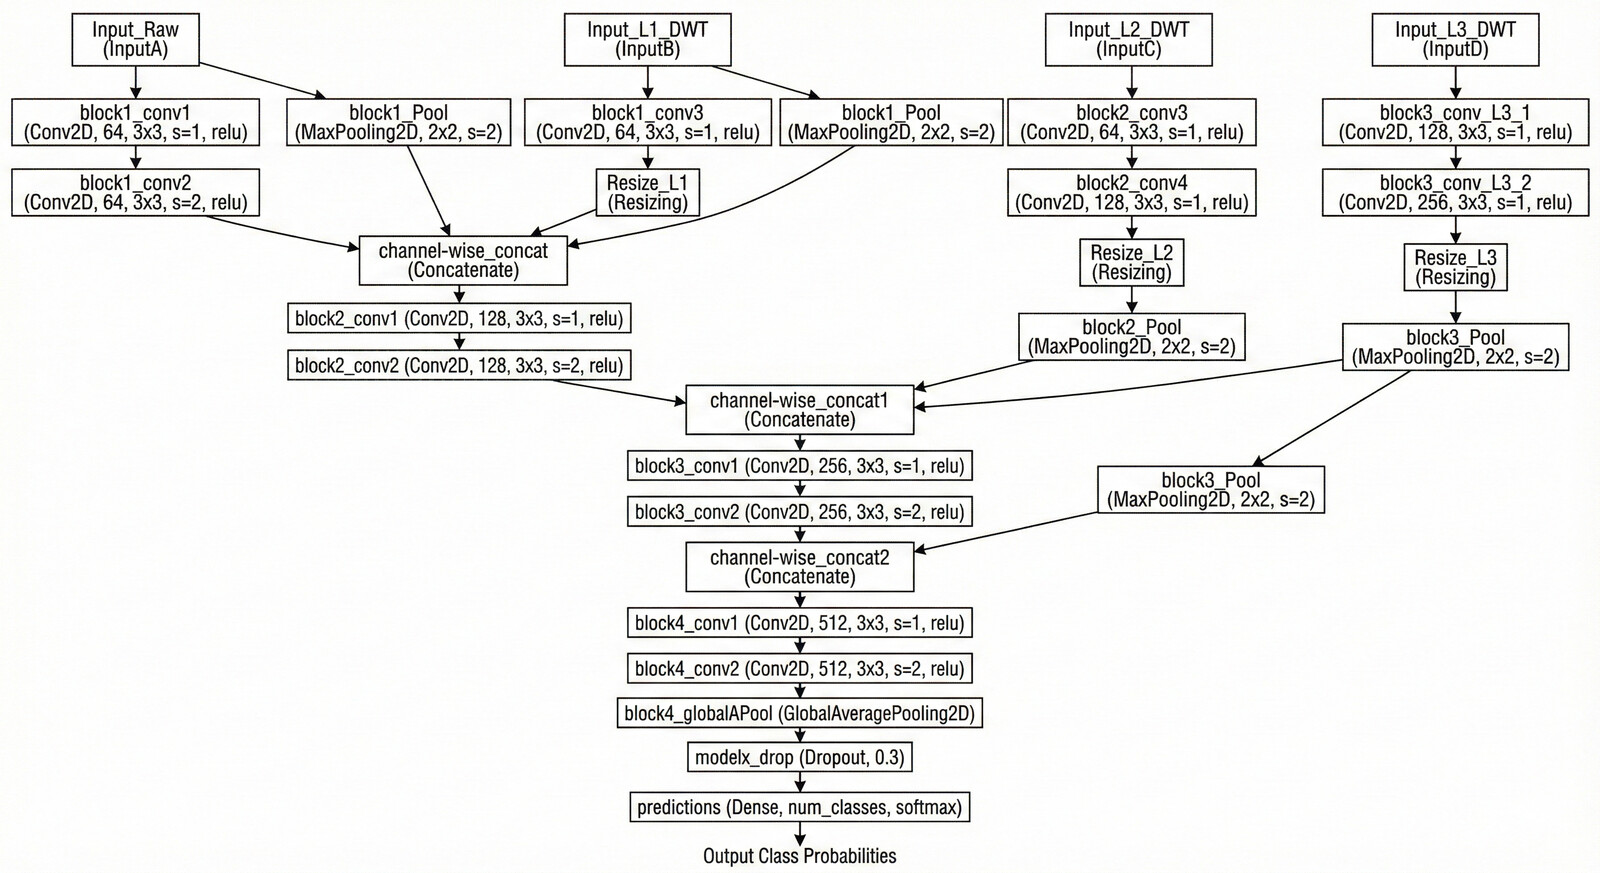 Diagrama esquemático de la arquitectura funcional de 4 ramas diseñada para este trabajo. Muestra la convergencia jerárquica de la rama espacial con las subbandas de aproximación wavelet a través de bloques convolucionales y capas de redimensionamiento.
Callbacks y Control Dinámico de Entrenamiento (EarlyStopping)
Para entrenar este modelo de más de 8.6 millones de parámetros sobre conjuntos con volumen de muestras limitado (evitando el memorismo y sobreajuste), configuré una estrategia activa de callbacks:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
from keras.callbacks import EarlyStopping, ReduceLROnPlateau, ModelCheckpoint, CSVLogger

early = EarlyStopping(
    monitor='val_accuracy',
    min_delta=0,
    patience=10,           # Tolerancia de épocas sin mejora
    verbose=1,
    mode='max',
    restore_best_weights=True
)

reduce_lr = ReduceLROnPlateau(
    monitor='val_loss',
    factor=0.1,
    patience=2,
    min_lr=1e-6
)

checkpoints = ModelCheckpoint(
    filepath='best_weights.weights.h5',
    monitor='val_loss',
    save_best_only=True
)

csv_logger = CSVLogger('metrics_history.csv')
EarlyStopping evitó entrenar épocas redundantes:
- En
coif1, el aprendizaje se estancó rápidamente y el callback interrumpió en la época 23 (restaurando la 13) con 240.76 s. - En
bior1.1, cortó en la época 27 (restaurando la 17) con 269.75 s. - En
haar, progresó hasta la época 42 (restaurando la 32) con 516.93 s. - En
sym2, la estabilidad del gradiente sostuvo la optimización hasta la época 63 (restaurando la 53) y totalizando 614.61 s antes de converger.
La Realidad del Cómputo: ¿Por qué fue forzosa una GPU NVIDIA L4 de 24 GB y >24 GB de RAM?
El flujo de cuatro tensores de entrada y capas Resizing/concatenate genera un consumo de recursos masivo que hace imposible correr estas pruebas en computadoras portátiles o GPUs comerciales de 8-12 GB:
- Régimen FMD: Cada época tomaba de 8 a 10 segundos (~440-460 ms por paso de lote). Una sola ejecución oscilaba entre 4 y 10 minutos.
- Régimen KTH-TIPS-2b y DTD con Generadores de Aumentación: Al activar
ImageDataGeneratory cargar en paralelo las transformadas multiescala, el coste por época subió a 38 - 44 segundos por época. Una sola corrida individual demandó entre 2,230 y 2,274 segundos (más de 37 a 38 minutos por cada modelo entrenado). - Escala Global: Al multiplicar ~38 minutos por 5 familias de ondículas y los distintos barridos experimentales, el tiempo de cálculo continuo acumuló decenas de horas de cómputo ininterrumpido.
- VRAM de 24 GB (NVIDIA L4 en Google Cloud): Cada rama mantiene tensores intermediarios en memoria de video. Una GPU de 8 o 12 GB arroja inmediatamente errores de desbordamiento (CUDA Out Of Memory) al intentar realizar la retropropagación a través de las capas de concatenación.
- Memoria RAM de Sistema (>24 GB): Mantener en RAM las matrices de coeficientes generadas por PyWavelets para miles de imágenes de alta resolución sin generar bloqueos de paginación (swap) ni muertes del kernel (kernel death en Google Colab) requirió instancias equipadas con más de 24 GB de memoria principal.
4. Resultados Cuantitativos
La evaluación experimental sobre ambos conjuntos de datos reveló dos regímenes de comportamiento totalmente distintos, ilustrando la interacción entre la física de la superficie y la formulación matemática de cada ondícula.
4.1. Flickr Material Database (FMD - Experimento 108): El Reto “In The Wild”
FMD representa el escenario de máxima complejidad debido a su gran variabilidad intra-clase, fondos arbitrarios e iluminación no controlada. Al evaluar mi arquitectura funcional de 4 ramas desde cero (sin pesos pre-entrenados), cuyos registros originales yacen en el cuaderno de Google Colab FMD-arc2b-mulexp-old.ipynb, las cinco familias obtuvieron las siguientes métricas en test:
| Familia Wavelet | Longitud ($L$) | Exactitud (%) | Pérdida (Loss) | Precisión | Recall | F1-Score |
|---|---|---|---|---|---|---|
sym2 ($N=2$) | 4 | 34.50% | 2.6994 | 0.3581 | 0.3450 | 0.3484 |
haar ($N=1$) | 2 | 34.00% | 2.1986 | 0.3549 | 0.3400 | 0.3287 |
db10 ($N=10$) | 20 | 31.50% | 2.3053 | 0.3242 | 0.3150 | 0.3143 |
bior1.1 ($N=1$) | 2 | 24.00% | 2.1410 | 0.4390 | 0.2400 | 0.2043 |
coif1 ($N=2$) | 6 | 23.00% | 2.1912 | 0.3854 | 0.2300 | 0.1884 |
- Comportamiento del Modelo Base (Sin Wavelet): La CNN equivalente sin ramas espectrales mostró una matriz de confusión completamente dispersa, incapaz de diferenciar materiales como follaje, vidrio o plástico. Sin la inyección analítica de subbandas, las capas iniciales desperdician capacidad representacional en intentar inferir filtros de frecuencia elemental.
- Dominio de bases compactas:
sym2yhaarlograron el mejor equilibrio. Al tener soportes cortos ($L=4$ y $L=2$), preservan la rugosidad física de las muestras sin contaminar los bordes en las capas de menor resolución.
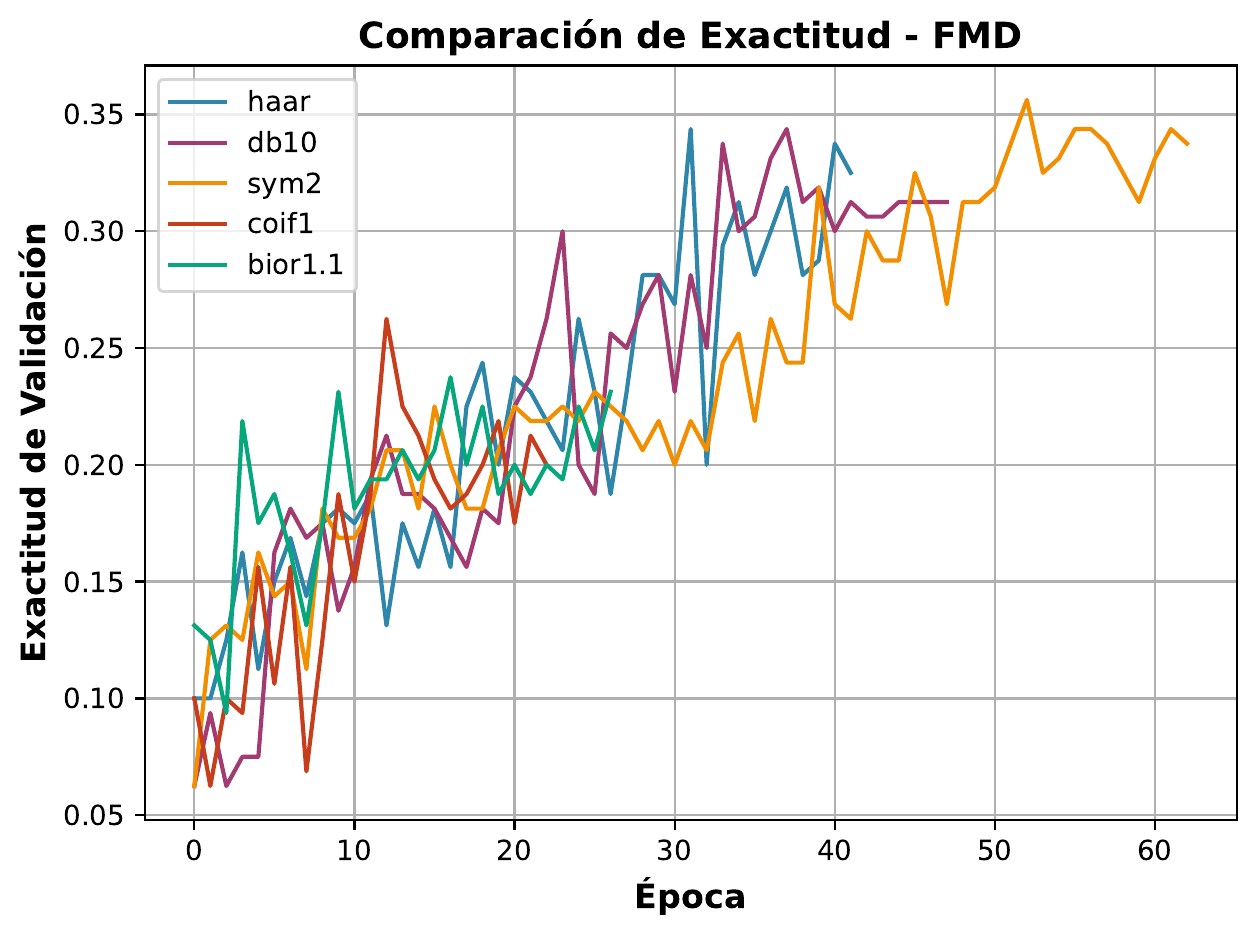 Evolución de la exactitud durante el entrenamiento para las 5 familias en FMD (Experimento 108). Symlet 2 y Haar sostienen una progresión estable sin colapsar por sobreajuste temprano.
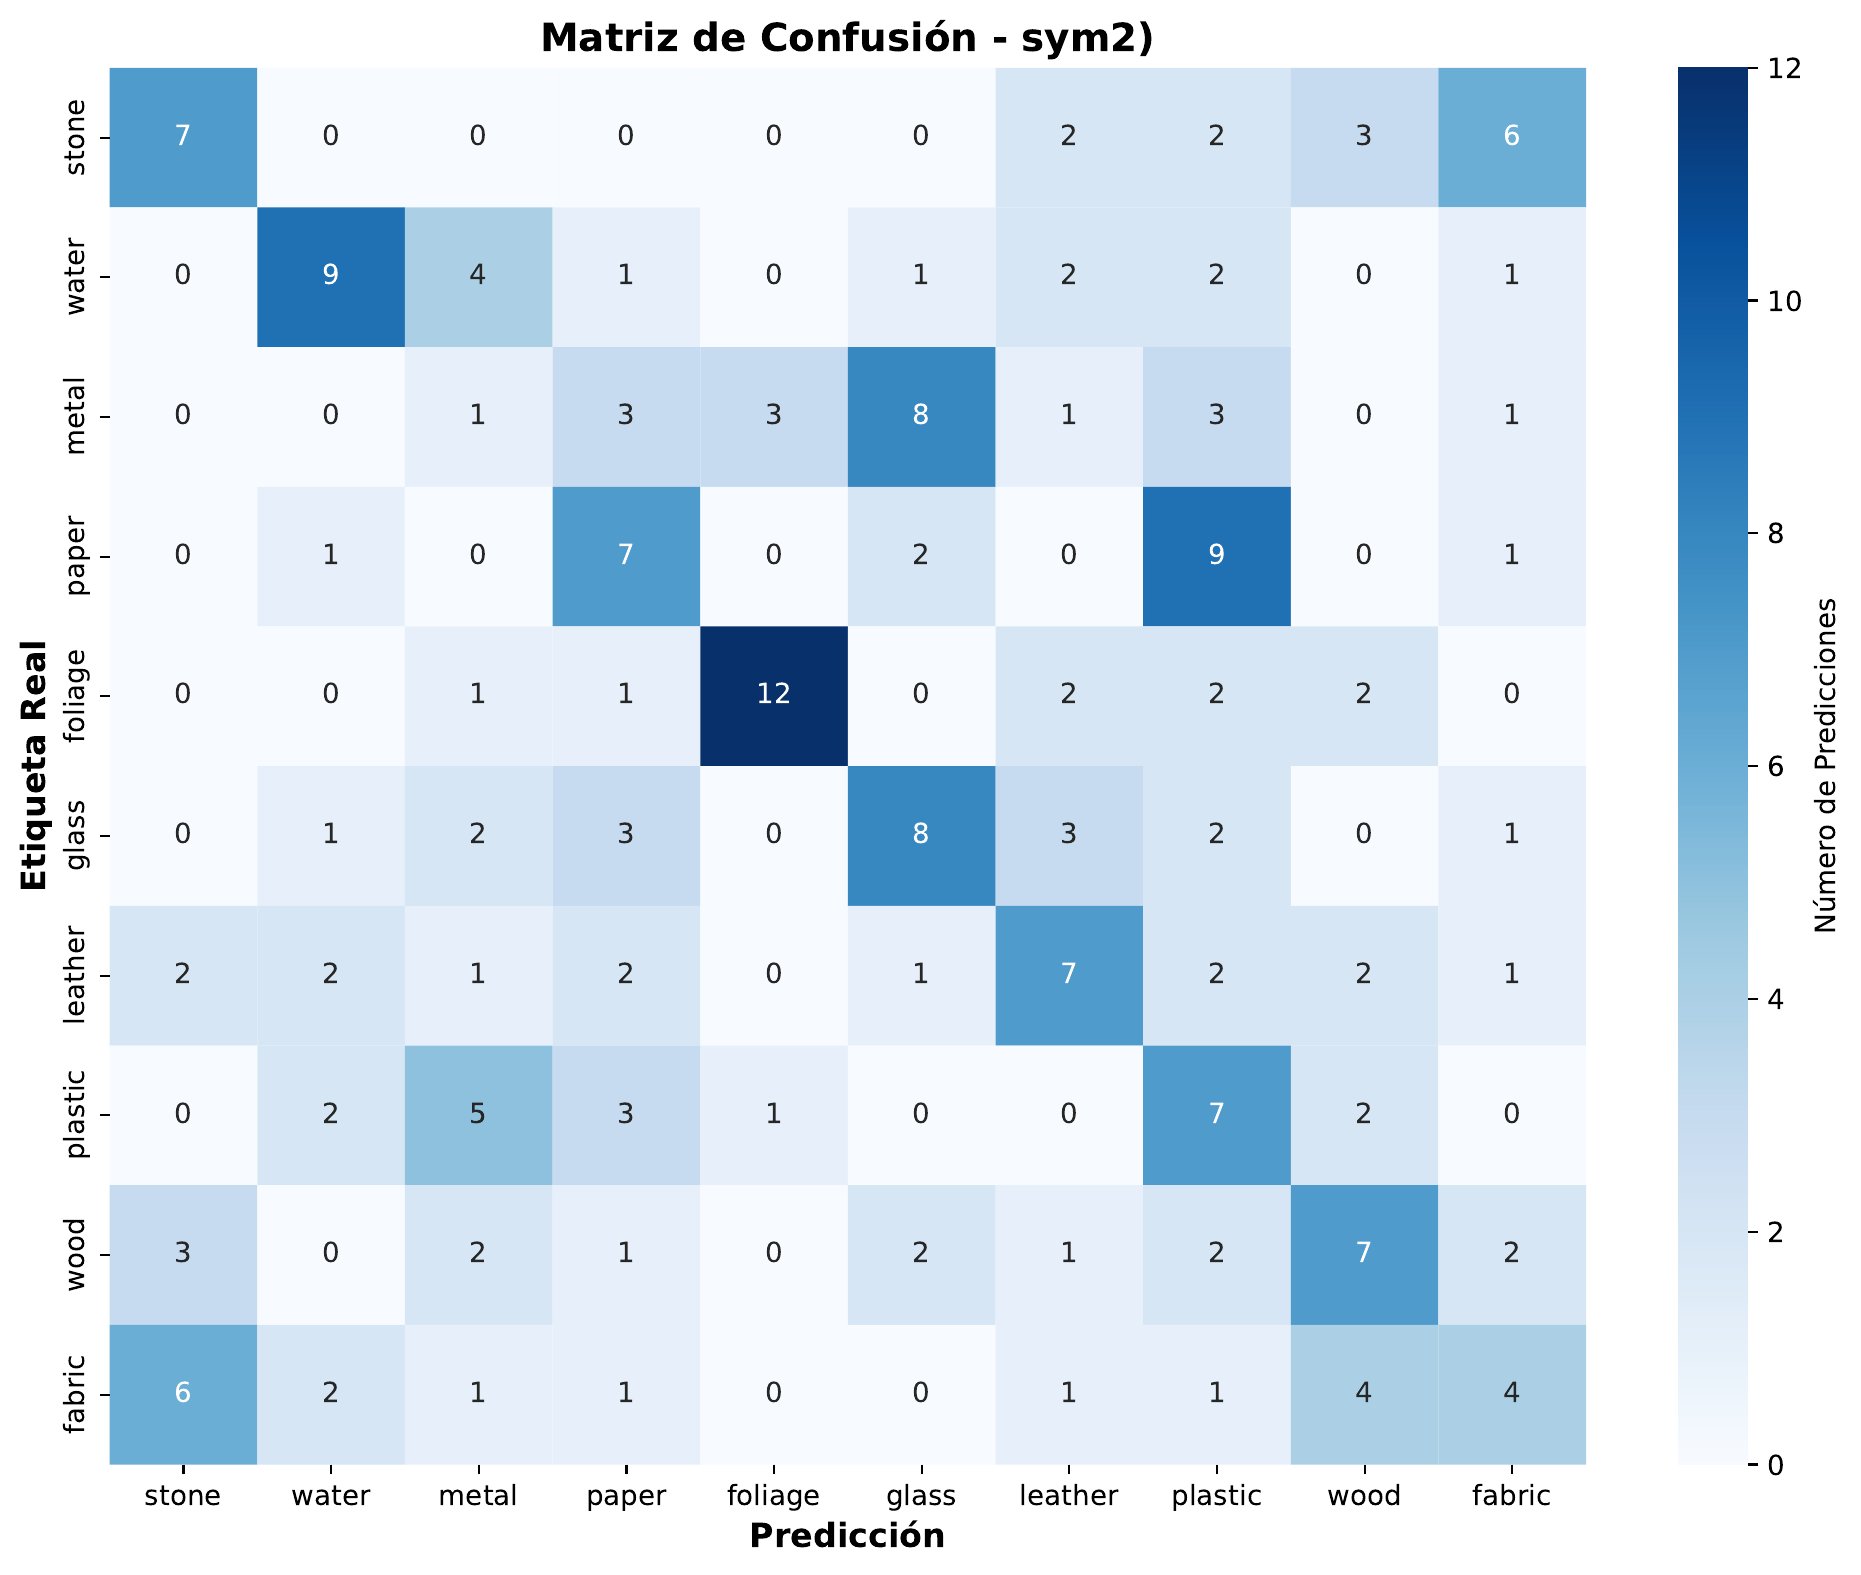 Matriz de confusión del modelo con wavelet
sym2 en FMD (Experimento 108). Se aprecia una diagonal principal notablemente definida en categorías con micro-rugosidades complejas.
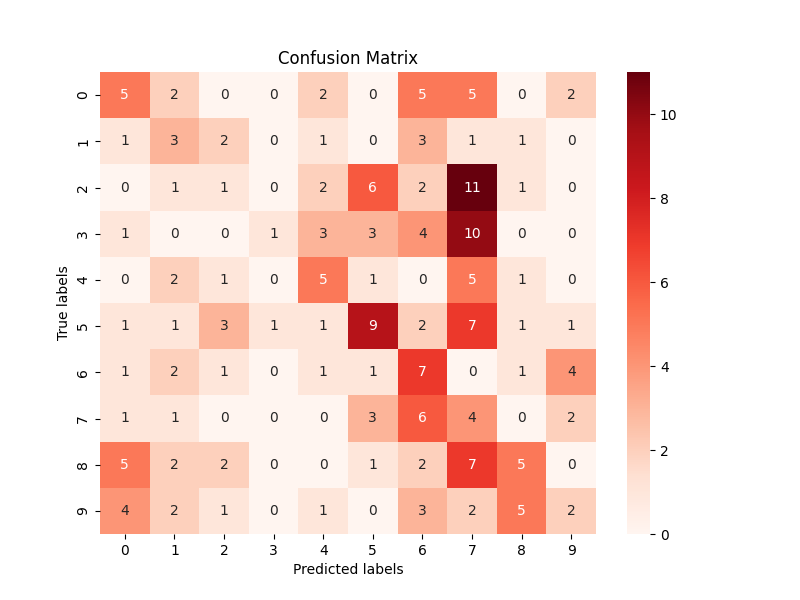 Matriz de confusión del modelo CNN base (sin wavelets) en FMD. La dispersión de predicciones ilustra la incapacidad de discriminar materiales sin la guía de características espectrales previas.
4.2. KTH-TIPS-2b (Experimento 10): El Salto Espectacular (>96% a 98.5%)
En contraste radical con FMD, el benchmark industrial KTH-TIPS-2b examina 11 categorías de materiales bajo variaciones controladas de escala, ángulo de iluminación y pose (4,752 imágenes).
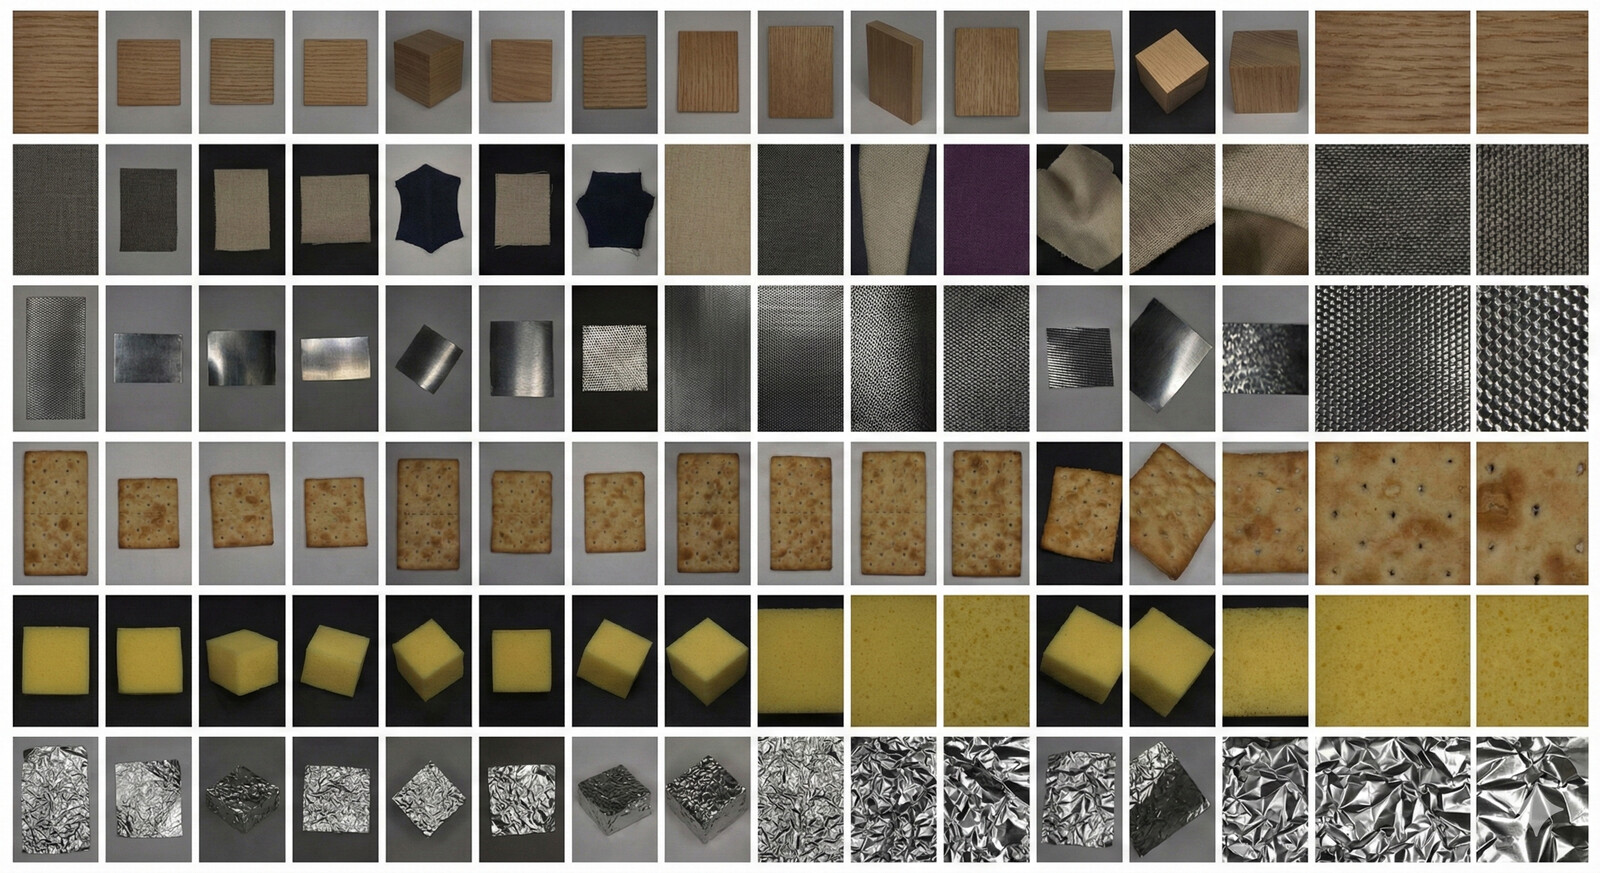 Muestras de materiales del benchmark KTH-TIPS-2b evaluadas en mi investigación. La variación paramétrica controlada de iluminación y ángulo de pose permitió a la arquitectura funcional extraer firmas espectrales sin interferencia de fondos ruidosos.
Aquí la arquitectura funcional multiescala demostró su verdadero potencial. Como quedó registrado en las celdas de evaluación del cuaderno KHT-TIPS2_arc1b-multexp.ipynb, todas las familias superaron el 96% de exactitud, con un desempeño sobresaliente en las 880 muestras de prueba:
| Familia Wavelet | Exactitud (%) | Pérdida (Loss) | Precisión | Recall | F1-Score | Aciertos / Total | Tasa de Error | Tiempo GPU (L4) |
|---|---|---|---|---|---|---|---|---|
db10 ($N=10$) | 98.52% | 0.0430 | 0.9854 | 0.9852 | 0.9853 | 867 / 880 | 1.48% (13 err) | 3,255 s (~54.3 min, 88 épocas) |
sym2 ($N=2$) | 98.18% | 0.0895 | 0.9825 | 0.9818 | 0.9819 | 864 / 880 | 1.82% (16 err) | 2,612 s (~43.5 min, 73 épocas) |
bior1.1 ($N=1$) | 97.16% | 0.0885 | 0.9730 | 0.9716 | 0.9717 | 855 / 880 | 2.84% (25 err) | 1,899 s (~31.6 min, 51 épocas) |
haar ($N=1$) | 96.93% | 0.0852 | 0.9695 | 0.9693 | 0.9693 | 853 / 880 | 3.07% (27 err) | 1,910 s (~31.8 min, 52 épocas) |
coif1 ($N=2$) | 96.25% | 0.1118 | 0.9640 | 0.9625 | 0.9622 | 847 / 880 | 3.75% (33 err) | 1,756 s (~29.3 min, 52 épocas) |
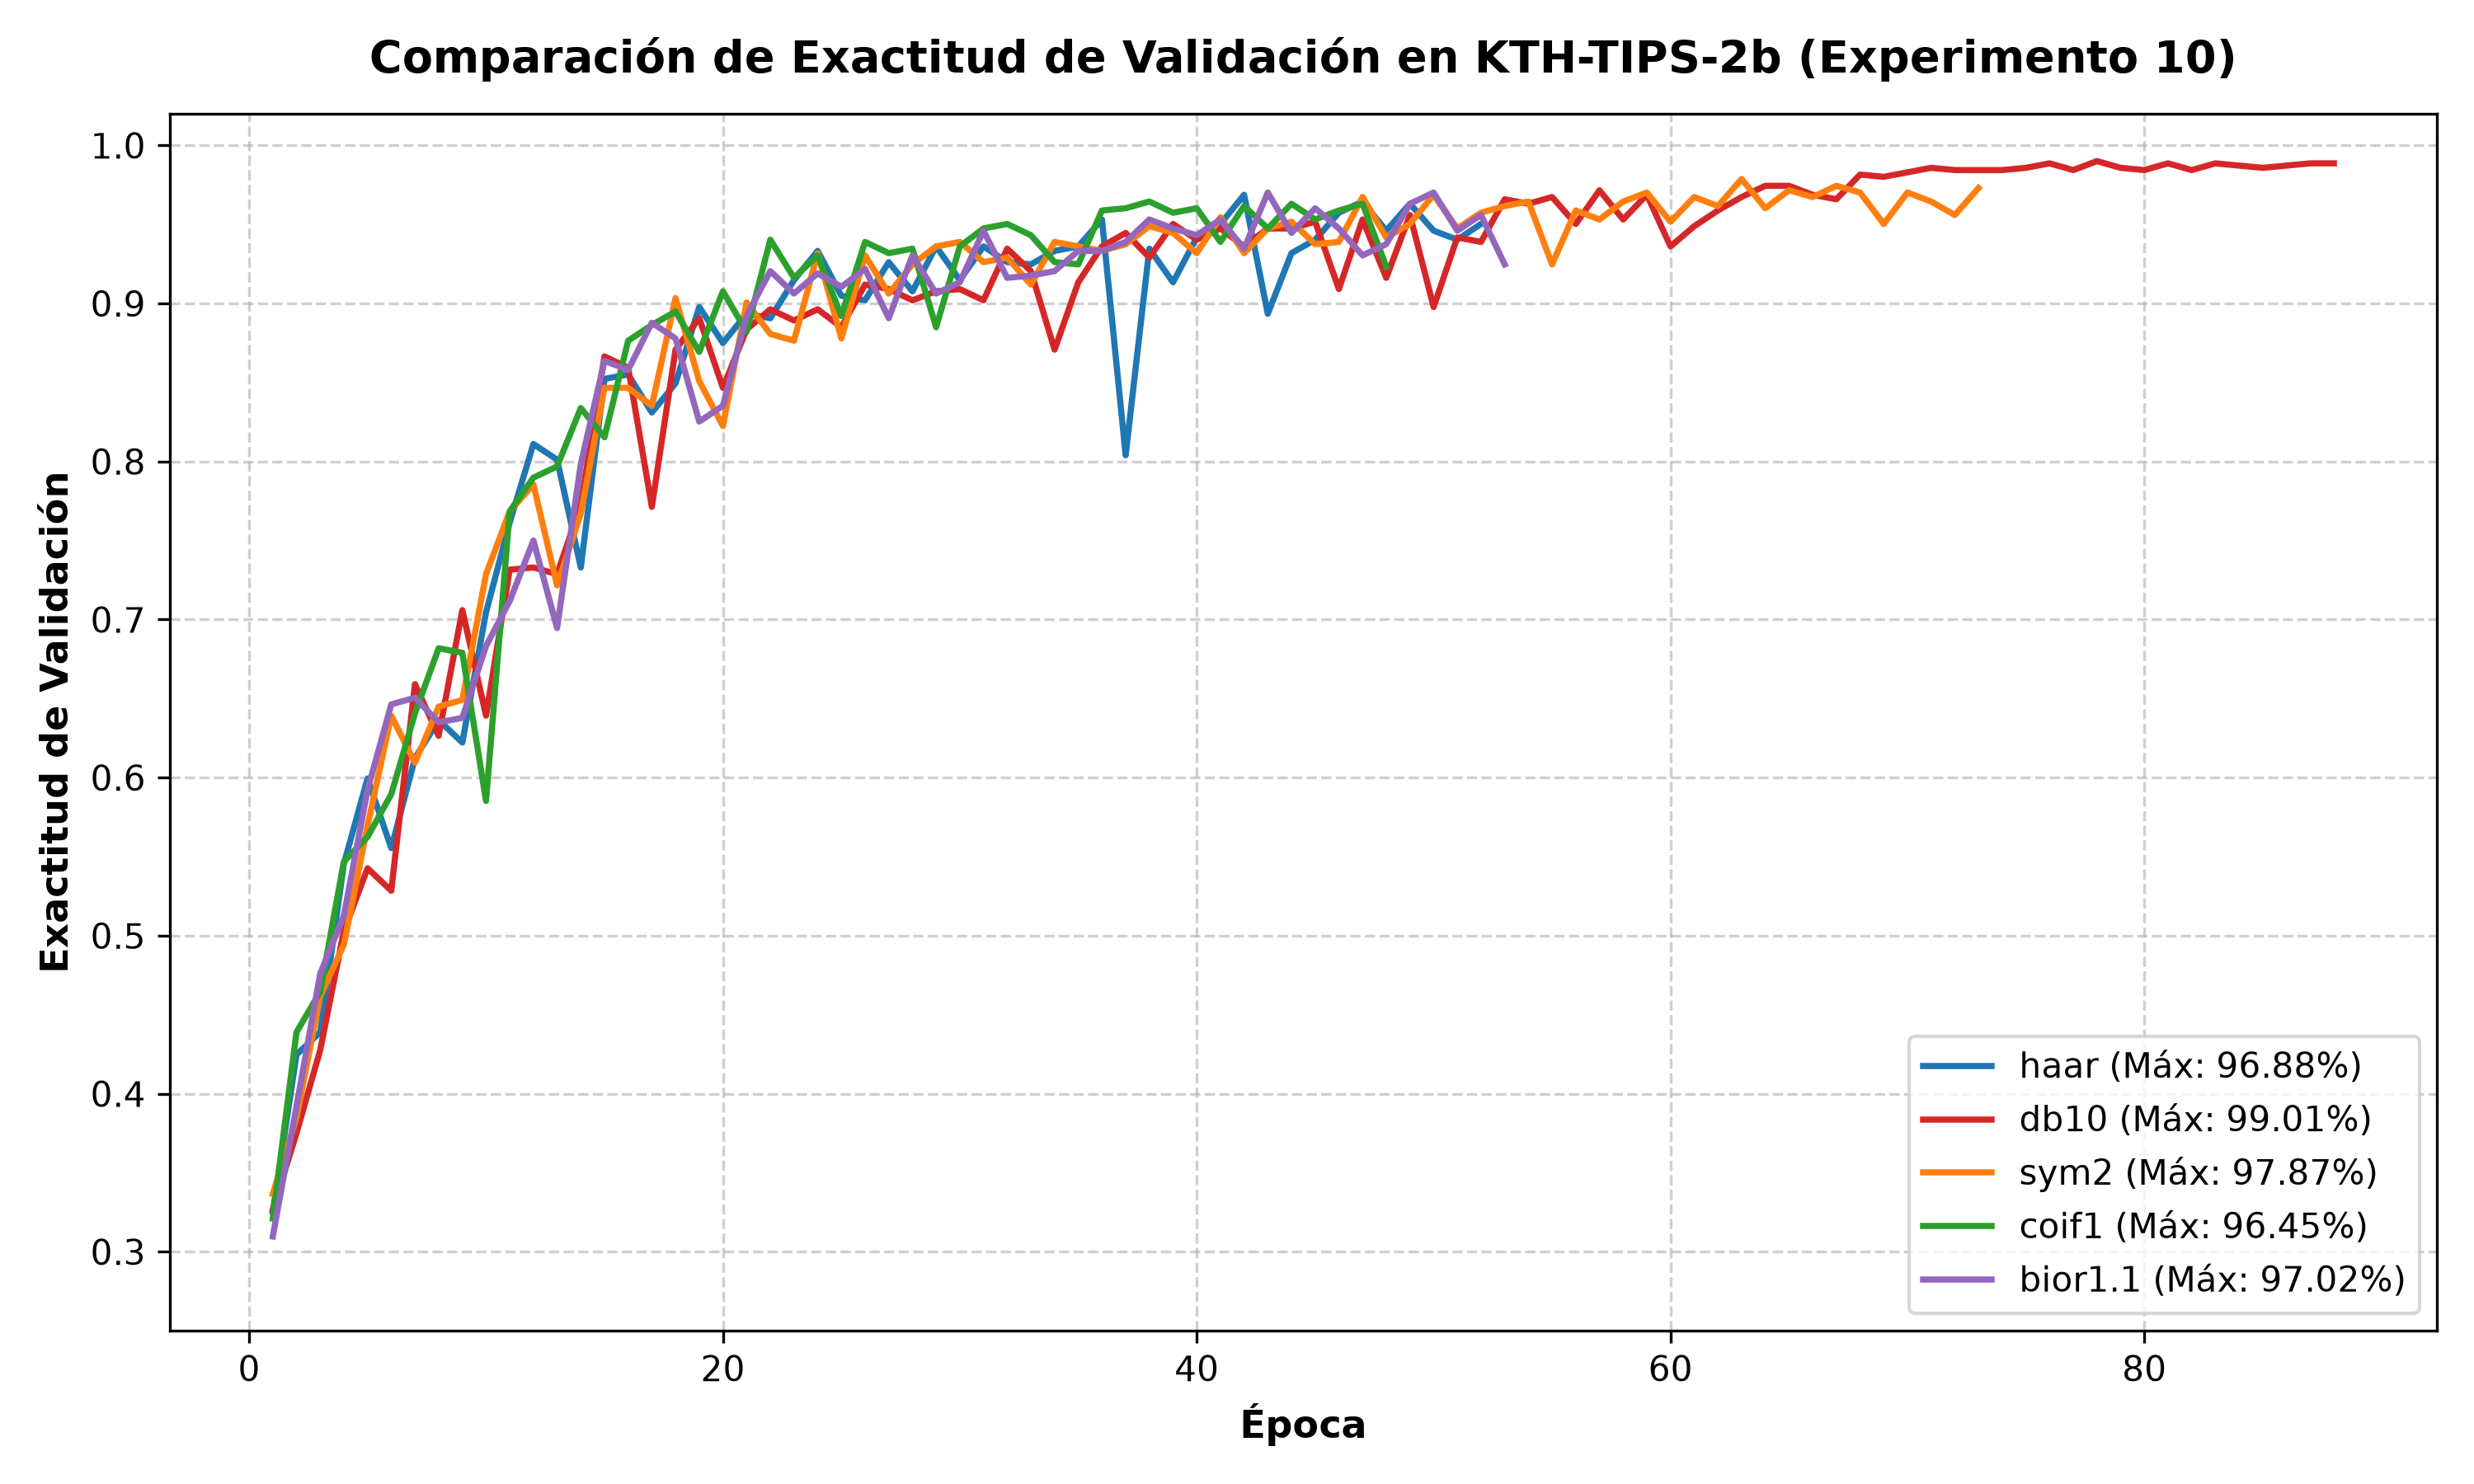 Evolución de la exactitud de validación durante el entrenamiento en KTH-TIPS-2b (Experimento 10). Las cinco familias superan con creces el 90% a partir de la época 20.
db10 sostuvo un aprendizaje continuo hasta la época 88, alcanzando un pico de 99.01% de exactitud en validación.
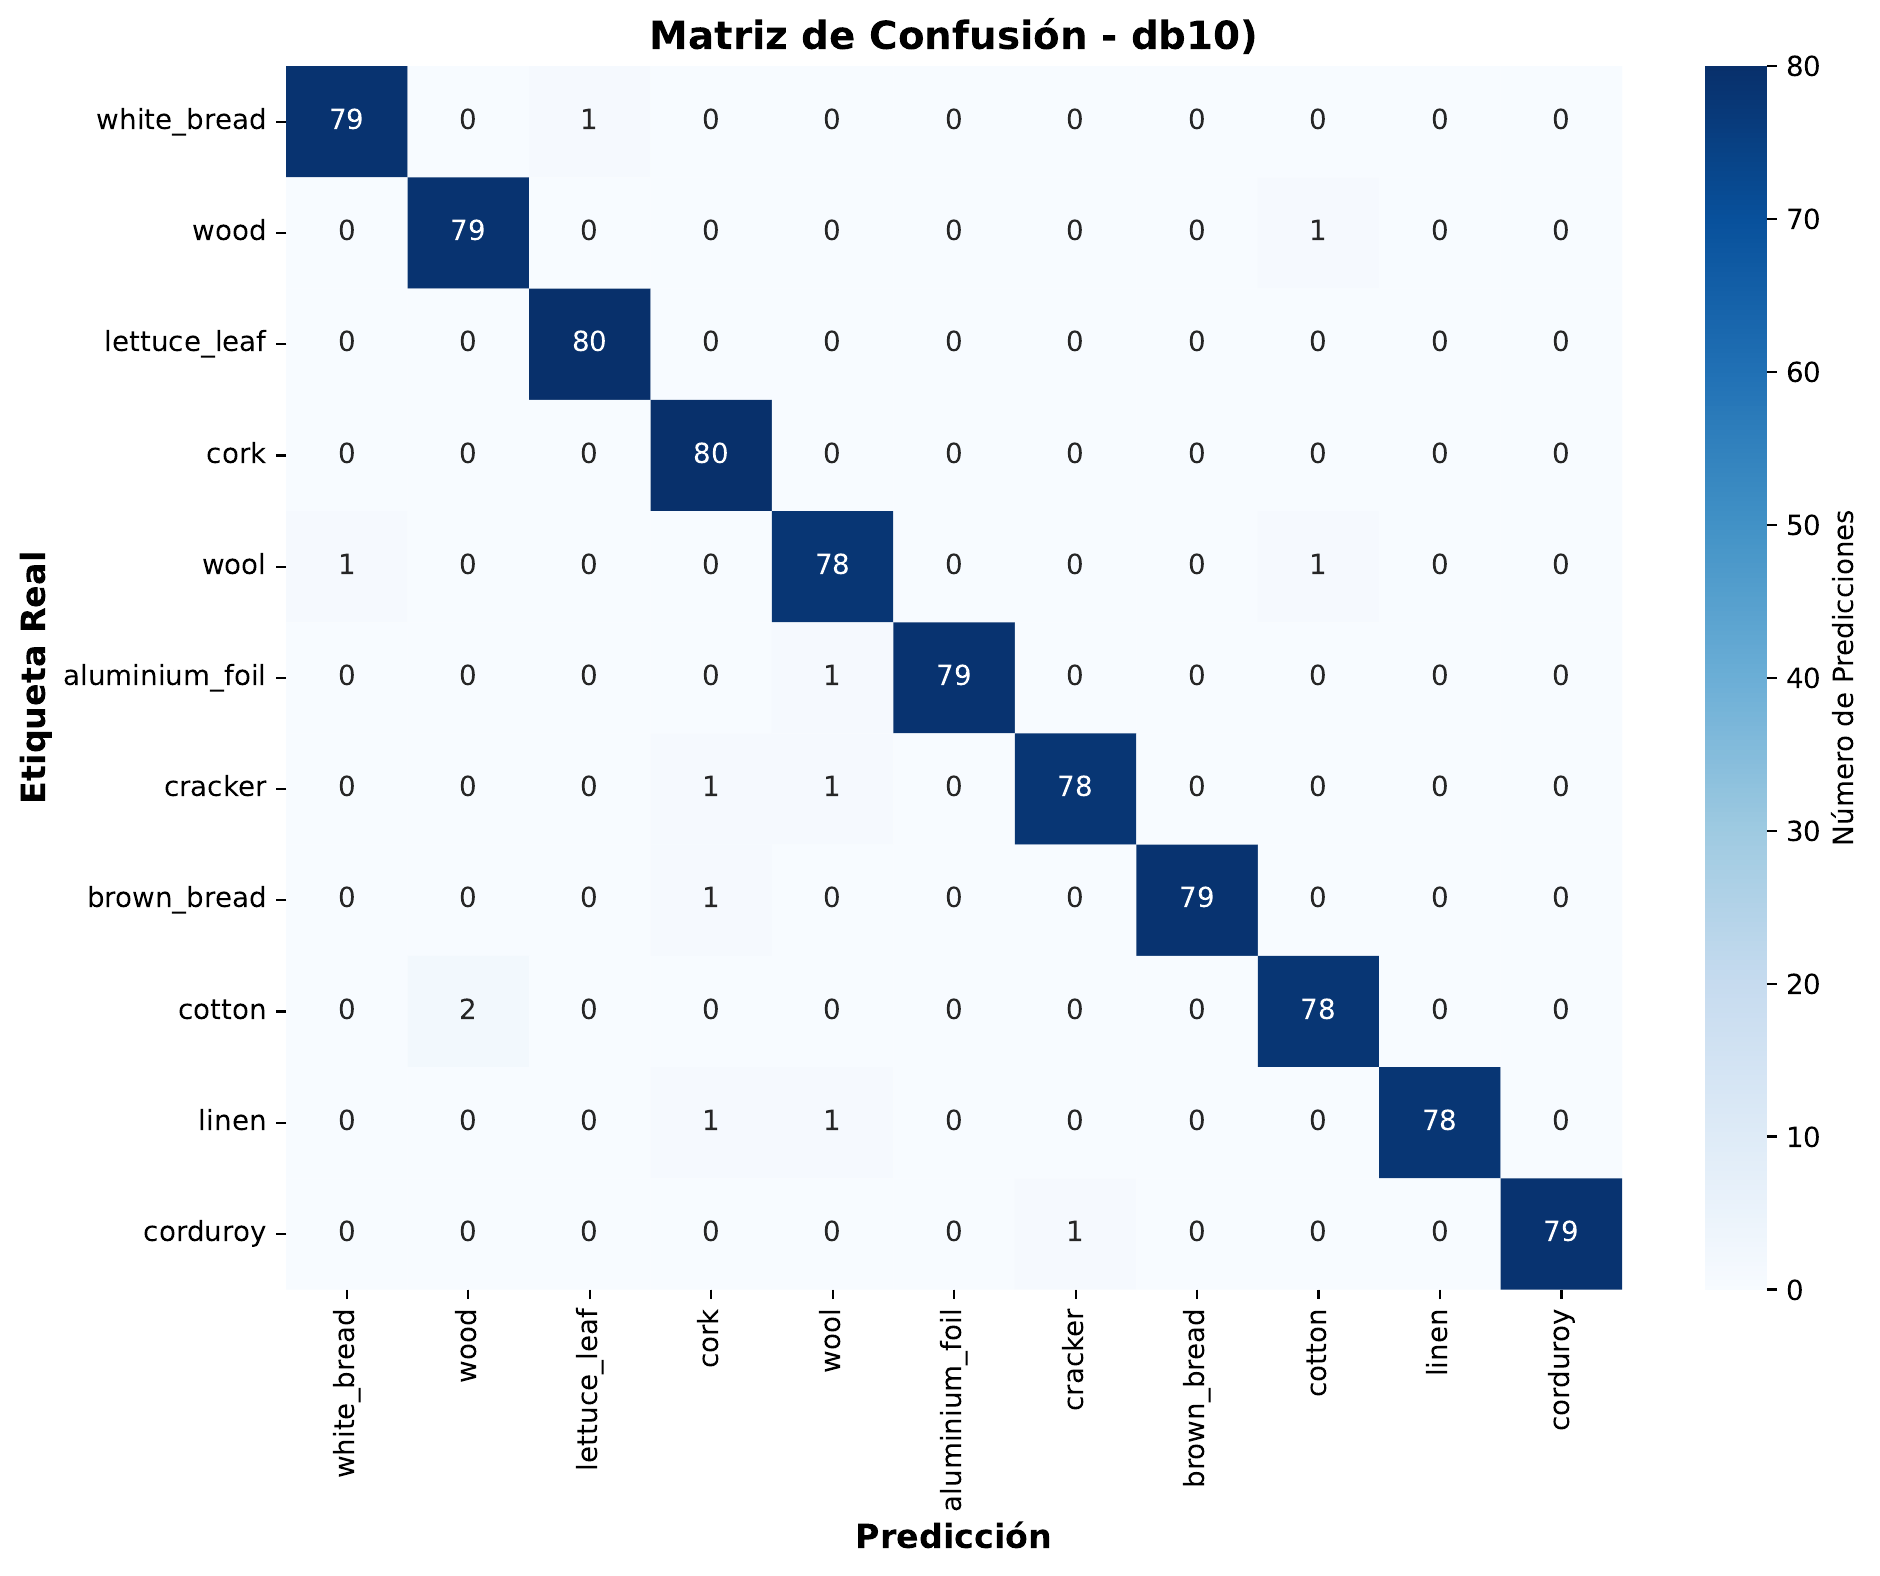 Matriz de confusión del modelo con wavelet
db10 en KTH-TIPS-2b (Experimento 10). En las 11 clases de materiales (white_bread, wood, lettuce_leaf, cork, wool, aluminium_foil, cracker, brown_bread, cotton, linen, corduroy), la diagonal principal concentra 867 aciertos sobre 880 muestras evaluadas (únicamente 13 errores de predicción).
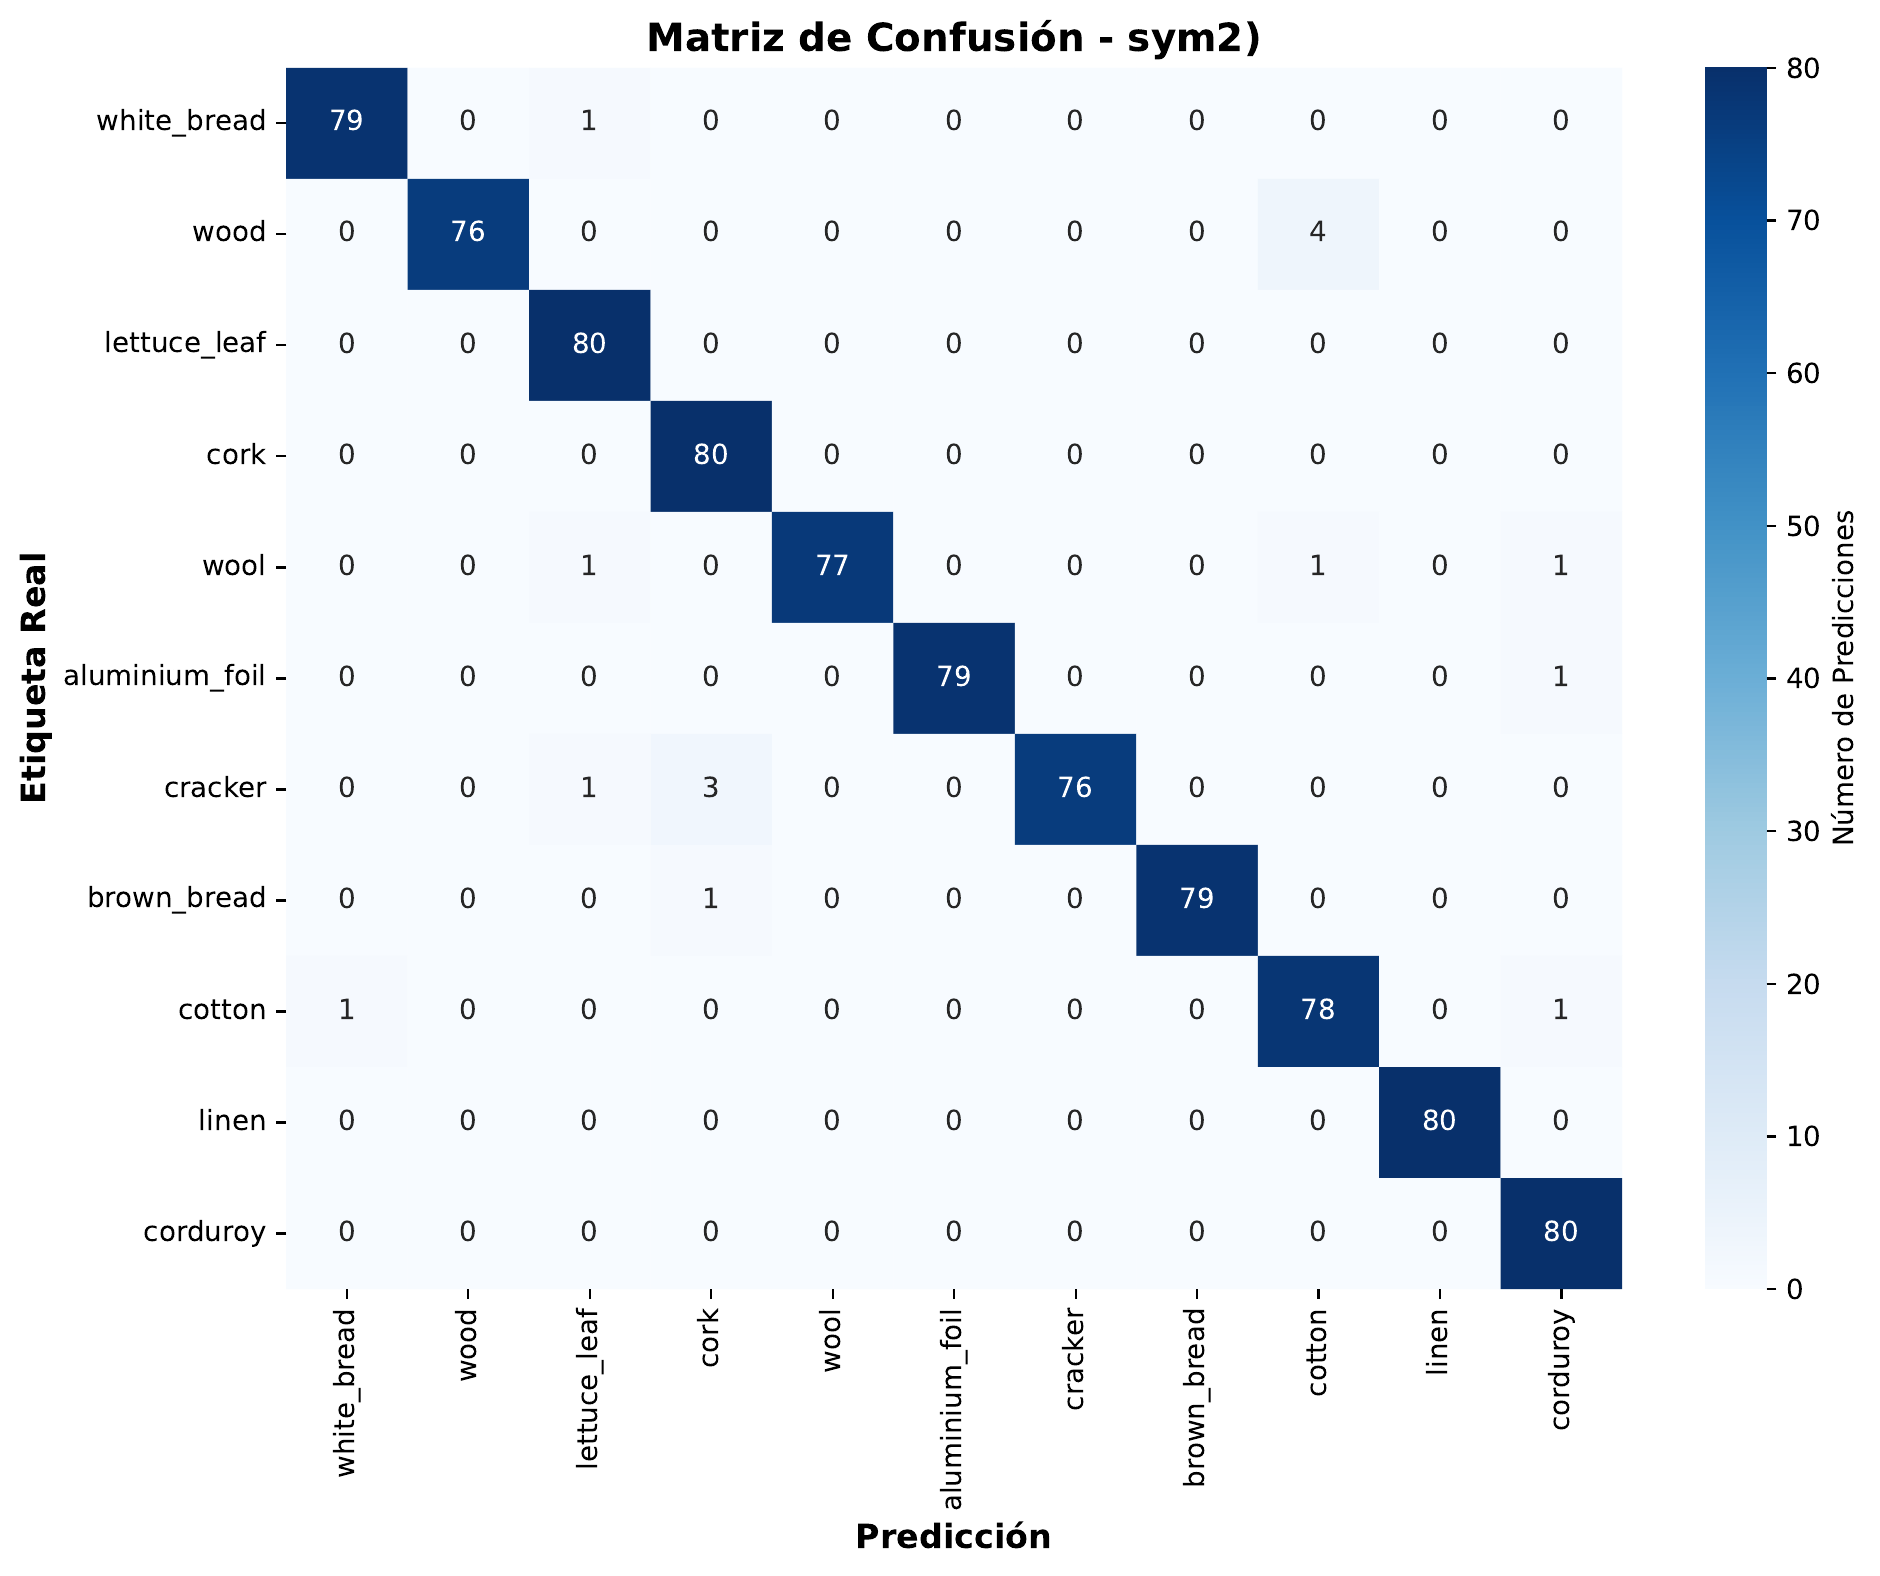 Matriz de confusión de la arquitectura funcional con wavelet
sym2 en KTH-TIPS-2b (Experimento 10). Con 864 aciertos sobre 880 muestras (98.18% de exactitud y 16 errores totales), confirma la robustez de los Symlets bajo variaciones controladas de escala e iluminación.
¿Por qué db10 y sym2 brillan en KTH-TIPS-2b?
Este contraste empírico representa uno de los aportes centrales de mi investigación:
- Gradientes continuos de iluminación: A diferencia de las discontinuidades abruptas y fondos ruidosos de FMD, en KTH-TIPS-2b los cambios lumínicos sobre las texturas puras generan transiciones suaves y diferenciables en el espacio bidimensional.
- El poder de los momentos de desvanecimiento ($p=10$): La wavelet
db10posee 10 momentos nulos, lo que le permite anular componentes polinomiales de baja y media frecuencia para modelar con exactitud analítica las variaciones sutiles de sombra y gradación de luz sobre la superficie. - Mínimo margen de error: Cometer únicamente 13 errores en 880 clasificaciones (98.52% con
db10) y 16 errores (98.18% consym2) valida que la integración jerárquica de subbandas wavelet resuelve con solvencia la clasificación de materiales cuando la información espectral no está enmascarada por artefactos de fondo. - Criterio de parada temprana (EarlyStopping): Las diferencias de tiempo de cómputo (desde 29.3 min en
coif1hasta 54.3 min endb10sobre la GPU NVIDIA L4) reflejan cómo el callback detuvo el entrenamiento tras 10 épocas sin mejora en la pérdida de validación, evitando el sobreajuste y preservando los mejores pesos del modelo (restore_best_weights=True).
5. Análisis Técnico: La Dualidad entre Soporte y Regularidad
El contraste entre FMD y KTH-TIPS-2b resuelve la aparente contradicción en el comportamiento de las ondículas:
1. La Paradoja de la Longitud del Soporte frente al Tamaño del Tensor
En matemáticas puras, tener $p = 10$ momentos de desvanecimiento permite que la ondícula anule polinomios hasta grado 9, otorgando una capacidad excepcional de compresión en señales suaves. Sin embargo, para lograr 10 momentos, Daubechies requiere un filtro con longitud de $L = 20$ coeficientes.
Cuando la imagen se reduce recursivamente a lo largo de 3 niveles: \(300 \to 150 \to 75 \to 38\)
En el nivel 3, las subbandas tienen una resolución espacial de solo $38 \times 38$. Un filtro de 20 coeficientes abarca más del 52% del ancho total de la imagen.
Durante la convolución discreta, para procesar los bordes es forzoso aplicar extensión de frontera (boundary padding, ya sea simétrica, periódica o por reflexión). En un tensor de $38 \times 38$ con un filtro de tamaño 20, los artefactos de borde sintéticos contaminan una proporción abrumadora de los coeficientes de salida. La red termina aprendiendo la matemática del padding en lugar de la firma física de la textura.
2. Eliminación de la Rugosidad por Exceso de Suavizado
La regularidad de una wavelet de Daubechies crece proporcionalmente con sus momentos de desvanecimiento ($C^{0.2p}$). La función $\psi(t)$ de db10 es sumamente suave y actúa como un filtro pasa-bajas sumamente estricto en la banda base, cancelando transiciones locales bruscas.
En el reconocimiento de materiales, el contraste sutil entre los hilos de un tejido o las imperfecciones de una piedra se manifiesta precisamente como singularidades no diferenciables. Al suprimir estas asperezas, db10 entrega representaciones descoloridas y homogéneas que confunden a la red neuronal.
En contraste, Haar ($L = 2$) es un operador de diferencia finita directa: \(h = \left[\frac{1}{\sqrt{2}}, \frac{1}{\sqrt{2}}\right], \quad g = \left[-\frac{1}{\sqrt{2}}, \frac{1}{\sqrt{2}}\right]\)
No suaviza la señal: actúa como un detector puntual de gradientes locales sin apenas artefactos de borde.
3. Simetría y Fase Lineal
La wavelet bior1.1 comparte el soporte ultracompacto de Haar ($L = 2$), pero añade simetría estricta. En procesamiento de señales, la simetría de los filtros garantiza fase lineal: \(\arg(H(\omega)) = -k\omega\)
La fase lineal asegura que todas las componentes frecuenciales sufran exactamente el mismo retraso temporal/espacial. Al apilar o procesar las subbandas en las capas convolucionales posteriores, las características visuales no sufren desalineaciones geométricas respecto al centro del parche.
Por su parte, sym2 (Symlets) fue formulada por Ingrid Daubechies como una modificación de mínima asimetría para solventar la distorsión de fase de Daubechies manteniendo ortogonalidad estricta. Esa combinación de soporte corto ($L = 4$), ortogonalidad y menor dispersión de fase le permitió alcanzar el F1-score más alto (0.3484) y la mejor exactitud global ($34.50\%$) en las texturas heterogéneas de FMD.
Conclusiones y Trazabilidad de Evidencias
Los experimentos sistemáticos realizados a lo largo de mi investigación desmitifican la noción de que una base matemática de mayor suavidad o regularidad teórica garantiza siempre mejores características para el aprendizaje profundo:
- La naturaleza del dominio visual determina a la ondícula óptima: En escenarios no controlados con ruido fotográfico y alta heterogeneidad (FMD), los soportes compactos (
sym2,haar) triunfan al evitar la distorsión por padding de frontera y la pérdida de asperezas. Por el contrario, en escenarios con variaciones físicas continuas de iluminación, pose y escala (KTH-TIPS-2b), los momentos de desvanecimiento elevados dedb10($p=10$) y la mínima asimetría desym2capturan transiciones suaves de luminancia de forma insuperable, alcanzando un 98.52% y 98.18% de exactitud (con apenas 13 y 16 errores en 880 muestras de prueba). - Potencia de la Fusión Jerárquica Multiescala: La arquitectura funcional multiescala de 4 ramas demostró que inyectar las aproximaciones espectrales ($cA$) en cada etapa piramidal de la CNN acelera la convergencia y supera drásticamente al modelo base sin wavelets, el cual queda estancado en matrices de confusión dispersas al tener que aprender representaciones básicas desde cero.
- Viabilidad computacional en hardware: Procesar simultáneamente 4 entradas a lo largo de más de 8.68 millones de parámetros evidenció que los filtros compactos estabilizan la optimización mucho más rápido bajo
EarlyStopping. La necesidad de GPUs NVIDIA L4 de 24 GB y más de 24 GB de RAM se justifica plenamente para alojar en memoria video y RAM los mapas de activación intermediarios de las 4 ramas sin provocar cuellos de botella por swap o saturación CUDA.
Evidencia y Cuadernos de Experimentación
Toda la experimentación cuantitativa reportada en este post está respaldada por registros directos de ejecución:
- Dataset FMD (Experimento 108): Implementado y evaluado en el cuaderno de Google Colab
FMD-arc2b-mulexp-old.ipynb, documentando el desempeño desym2(34.50% exactitud, F1-Score 0.3484) y el corte temprano por callbacks. - Dataset KTH-TIPS-2b (Experimento 10): Registrado en el cuaderno de Google Colab
KHT-TIPS2_arc1b-multexp.ipynb, evidenciando el salto a 98.52% de exactitud condb10(867 aciertos / 880 muestras) y 98.18% consym2(864 aciertos). - Dataset DTD (Atributos texturales): Desarrollado en el cuaderno de Google Colab
DTD-arc2b-mulexp.ipynbpara clasificación perceptual multiclase. - Código fuente y pipelines: El repositorio abierto 0gerardo0/Wavelet_CNN_Classifier alberga las funciones de preprocesamiento espectral, esquemas de descomposición y scripts de entrenamiento.
Referencias
Repositorio de Código del Proyecto: github.com/0gerardo0/Wavelet_CNN_Classifier — Implementación en Keras/TensorFlow, cuadernos de experimentación multiescala en GPU L4 y scripts de extracción DWT 2D.
Mallat, Stéphane (1989). A Theory for Multiresolution Signal Decomposition: The Wavelet Representation. IEEE Transactions on Pattern Analysis and Machine Intelligence, 11(7), 674–693. https://doi.org/10.1109/34.192463
Daubechies, Ingrid (1992). Ten Lectures on Wavelets. Society for Industrial and Applied Mathematics (SIAM), CBMS-NSF Regional Conference Series in Applied Mathematics, Vol. 61. https://doi.org/10.1137/1.9781611970104
Sharan, Lavanya; Liu, Ce; Rosenholtz, Ruth; Adelson, Edward H. (2014). Recognizing Materials in the Real World (Flickr Material Database). International Journal of Computer Vision (IJCV), 107(3), 207–222. https://doi.org/10.1007/s11263-013-0683-0
Caputo, Barbara; Hayman, Eric; Mallikarjuna, P.; Savarese, Silvio; Eklundh, Jan-Olof (2005). Classifying Materials in the Real World: The KTH-TIPS Database. Computational Vision and Active Perception Laboratory (CVAP), KTH Royal Institute of Technology. https://www.csc.kth.se/cvap/databases/kth-tips/
Cimpoi, Mircea; Maji, Subhransu; Kokkinos, Iasonas; Mohamed, Sammy; Vedaldi, Andrea (2014). Describing Textures in the Wild (DTD). IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 3606–3613. https://doi.org/10.1109/CVPR.2014.458
Simonyan, Karen; Zisserman, Andrew (2014). Very Deep Convolutional Networks for Large-Scale Image Recognition. International Conference on Learning Representations (ICLR 2015), arXiv:1409.1556. https://arxiv.org/abs/1409.1556
Lee, KangGeon; Choi, Dong-Min; Lee, Sang-Heon (2020). Wavelet-Based Convolutional Neural Network for Image Classification. IEEE Access, 8, 148560–148570. https://doi.org/10.1109/ACCESS.2020.3015947
PyWavelets Contributors (2019). PyWavelets: Wavelet Transforms in Python. Journal of Open Source Software, 4(36), 1237. https://pywavelets.readthedocs.io/